2分で読める生成AIのいま VOL.80 材料から見たAI ②-2 ― エージェントAIに必要な「部品」たち
新シリーズ「○○から見たAI」、材料編の後編(②-2)です。前回(②-1)はAIの「体」――シリコン・GPU・電力といったハードウェアの話でした。今回はその上で動くエージェントAI特有の「部品」――記憶・道具・思考回路――を見ていきます。医療の現場になじみ深い概念との、意外な共通点も出てきます。
(※2026年10月時点の情報です。)
今回も医療田さんと機械屋さんの会話でどうぞ。
======
機械屋:
前回は、AIを動かすハードウェア――シリコンやGPU、電力の話をしましたね。
今回はその続きで、エージェントAIに必要な「部品」を見ていきましょう。
医療田:
エージェントAIって、Vol.68でやったやつだよね。
自分で考えて、道具を使って、タスクをこなすAI。
機械屋:
そうです。
あの時は「構成と監督設計」という全体像の話でしたが、
今回はもう少し具体的に、エージェントAIを組み立てるのに必要な「部品」、
いわば「材料」に注目してみます。
医療田:
前回がAIの「骨格と筋肉」だとしたら、
今回は「臓器」の話っていうことかな。
機械屋:
いい例えですね。
ただ、前回は「学習(トレーニング)」に必要なハードウェアが中心でした。
エージェントAIを実際に動かすとなると、
まず、もうひとつ別のハードウェア要件があるんです。
● 推論のハードウェア ―― 「学習」と「実行」は別モノ
医療田:
学習と、実際に動かすのとでは、必要なものが違うの?
機械屋:
ええ。
AIの学習は、膨大なデータから「知識」を一度に焼き付ける作業です。
前回お話しした、数万個のGPUを使って何ヶ月もかける、あのプロセスですね。
一方、エージェントAIが実際にタスクをこなす時は「推論(インファレンス)」という処理を繰り返します。
医療田:
推論?
機械屋:
はい。
ユーザーの質問に答えたり、次の行動を決めたりする。
学習済みの知識を使って「考える」処理のことです。
医療田:
あー、、
学習が「医学部で6年間勉強すること」だとしたら、
推論は「外来で目の前の患者さんを診ること」みたいな感じ?
機械屋:
まさにそうです。
そして、ここが重要なんですが、
学習と推論では、ハードウェアのボトルネックが違うんです。
医療田:
ボトルネック?
機械屋:
学習は「計算量」がボトルネック。GPUの演算能力が命です。
でも推論は、「メモリ帯域」――データの流れる速度がボトルネックになる。
医療田:
なんで推論だとそうなるの?
機械屋:
推論のとき、AIは1つの単語を生成するたびに、
モデルが持つ数千億個のパラメータ――つまり「学習で焼き付けた知識」を使って計算します。
この知識はGPUの隣に搭載されたメモリチップに格納されていて、
GPUの計算コアがそこからデータを引っ張ってくるんですが、
計算自体は一瞬で終わるのに、データが届くのを待っている時間のほうが長くなる。
医療田:
、、ちょっと待って。
それって、心臓と血管の関係に似てない?
機械屋:
と、いいますと?
医療田:
心臓のポンプ力がいくら強くても、
血管が細かったら、臓器に十分な血液が届かないでしょ。
GPUの計算力が心臓だとしたら、
メモリ帯域は血管の太さ、っていうことかな。
機械屋:
、、素晴らしい。
まさにその通りです。
そして、この「血管を太くする」ための技術が「HBM」――High Bandwidth Memory、高帯域メモリです。
医療田:
HBM。
機械屋:
通常のメモリチップを横に並べるのではなく、
縦に積層する技術です。
シリコンチップに微細な穴を開けて縦方向に配線を通す――TSVという技術で、
データの「流路」を大幅に広げられる。
前回の「イレブンナイン」のシリコンウェハーの話と、直接つながっていますね。
医療田:
前回の素材が、ここにも効いてくるんだ。
で、それを作ってるのは?
機械屋:
韓国のSK Hynixが世界シェアの50〜55%を占めています。
Samsung、Micronが続きますが、
需要の伸びに供給が追いつかず、2027年以降まで供給不足が続くと予測されています。
医療田:
また特定の企業に集中してる。。
前回のレアアースと中国の話みたいだね。
機械屋:
ええ。
そしてエージェントAIの場合、推論の負荷がさらに大きくなります。
医療田:
なんで?
機械屋:
通常のチャットAIは、ユーザーの質問に1回答えれば終わりです。
でもエージェントAIは、1つのタスクに対して
「考える→行動する→結果を見る→また考える」を何度も繰り返す。
1タスクあたりの推論回数が、通常のAIの数倍から数十倍になるんです。
医療田:
あー、、
外来で1人の患者さんに対して、
問診して、検査オーダーして、結果確認して、追加検査して、、って何往復もするようなものか。
1人あたりの「診察コスト」が跳ね上がる。
機械屋:
おっしゃる通りです。
だからこそ、前回お話しした推論コストの劇的な低下――
3年で99.7%の下落――が、エージェントAI普及の大前提なんです。
コストが高いままでは、エージェントは「動かすたびに赤字」になってしまう。
医療田:
前回の話と、ここでつながるんだね。
機械屋:
ええ。
ハードウェアの話はここまでにして、
ここからは、このハードウェアの上で動くソフトウェアの「部品」を見ていきましょう。
● メモリ ―― AIの「記憶」には2種類ある
機械屋:
最初のソフトウェア部品は「メモリ」です。
医療田:
ん? メモリ?
さっきのHBMの話じゃないの?
機械屋:
ここがちょっとややこしいところなんですが、
同じ「メモリ」という言葉でも、レイヤーが違うんです。
HBMは、AIが「考える」ときにデータを高速にやり取りするための物理的なチップです。
さっきの例えで言えば、血管の太さ。
一方、これから話すメモリは、AIが「何を覚えているか」という仕組みの話です。
医療田:
、だったら別の話だね。
「メモリチップ」とソフトとしての「メモリ」は別物なのね?
機械屋:
まさにそうです。
HBMがいくら高速でも、AIが「前回何を話したか」を覚えていなければ、
エージェントとしては使い物にならない。
ハードウェアのメモリが「処理速度の基盤」だとすれば、
ソフトウェアのメモリは「知的な振る舞いの基盤」です。
医療田:
なるほど。。
じゃあ、AIって会話を覚えてるでしょ? それとは違うの?
機械屋:
いい質問です。
AIが会話を覚えている仕組みは「コンテキストウィンドウ」と呼ばれるもので、
これはいわば「ワーキングメモリ」――短期記憶です。
いま目の前にある情報を一時的に保持している状態ですね。
医療田:
ふんふん。
機械屋:
問題は、この短期記憶には容量制限があることです。
最新のモデルは「100万トークン対応」などと謳っていますが、
実際には13万トークンあたりから性能が落ち始めるという報告もあります。
実効的な容量は、広告の6〜7割程度なんです。
医療田:
、、テストの丸暗記みたいなもの?
詰め込みすぎると、最初のほうを忘れちゃう。
機械屋:
まさにそうです。
そこで必要になるのが「長期記憶」。
会話のたびに重要な情報を抽出して外部のデータベースに保存し、
次の会話の時に必要な情報だけを呼び出す仕組みです。
医療田:
あー、それって、、
患者さんの「カルテ」みたいなものだね。
毎回の診察で全部覚えてるわけじゃないけど、
カルテを見れば過去の経緯がわかる。
機械屋:
素晴らしい例えです。
実際、ある研究者はこれを「コンテキストウィンドウはRAM、長期記憶はハードディスク」と表現しています。
診察中に頭の中にある情報がRAM、
カルテや検査データベースがハードディスクにあたるわけですね。
医療田:
じゃあ、エージェントAIが「賢く」振る舞うためには、
この「カルテの読み書き」がちゃんとできないとダメなんだ。
機械屋:
おっしゃる通りです。
2026年現在、Mem0やLettaといったメモリ管理フレームワークが登場していて、
AIが自分で「何を覚えておくべきか」を判断して記憶を整理する仕組みも実用化されつつあります。
● ツール ―― AIの「手足」と、それをつなぐ規格
機械屋:
次の部品は「ツール」です。
エージェントAIが実際に世界に働きかけるための「手足」ですね。
医療田:
ツールって、たとえば?
機械屋:
Web検索、ファイルの読み書き、コードの実行、データベースへの問い合わせ、
カレンダーの操作、メールの送信。。
最近では、人間と同じようにマウスやキーボードでパソコンを操作する「コンピュータ・ユース」や、
ブラウザを自動操作する「ブラウザ・オートメーション」まであります。
医療田:
へー。
でも、それって、ツールごとに接続方法がバラバラだったら大変じゃない?
機械屋:
まさにその問題を解決するために生まれたのが、
MCP――Model Context Protocolです。
Vol.12で紹介しましたね。
医療田:
あ、あった気がする。AIの「マスター鍵」って言ってたやつ?
機械屋:
そうです。
MCPは2024年11月にAnthropic社が発表したオープン規格で、
AIとツールをつなぐための共通プロトコルです。
開発者はMCPに一度対応するだけで、
あらゆるAIモデルからそのツールを呼び出せるようになります。
医療田:
、、あ、それって、
医療画像のDICOMに似てるね。
機械屋:
おっしゃる通りです。
DICOMがCTやMRI、エコーなどメーカーの違う医療機器を共通フォーマットでつないだように、
MCPはSlackやGmail、データベースなど種類の違うツールを共通プロトコルでつなぐ。
発想はまったく同じです。
医療田:
DICOMがなかったら、CTの画像をMRIのワークステーションで見られないもんね。
MCPがなかったら、AIもツールごとに別の接続を作らなきゃいけないんだ。
機械屋:
ええ。
そして、MCPは2026年現在、OpenAI、Google、Microsoftも採用を表明しています。
Anthropicがこの規格をLinux Foundation傘下の財団に寄贈したことで、
業界標準としての地位がほぼ確立しました。
医療田:
DICOMの時もそうだったけど、
「規格の統一」って、地味だけどめちゃくちゃ大事だよね。
● 推論ループ ―― AIの「思考回路」
機械屋:
最後の部品は「推論ループ」です。
メモリとツールが揃っても、
それを「いつ、どの順番で、どう使うか」を決める仕組みがなければ、
エージェントAIは動けません。
医療田:
なるほど、、脳みそはあって、手足もあるけど、
「考えて動く回路」がないと、ただの置物ってこと?
機械屋:
そうです。
現在主流のアプローチは「ReAct」と呼ばれるフレームワークで、
Think(考える)→ Act(行動する)→ Observe(結果を観察する)
このサイクルを繰り返すことで、AIが自律的にタスクを遂行します。
医療田:
、、。
ねえそれ、医者の診断プロセスとそっくりじゃない?
機械屋:
と、いいますと?
医療田:
だって、
仮説を立てる(Think)→ 検査をオーダーする(Act)→ 結果を見る(Observe)→ 仮説を修正する(Think)。
これ、臨床推論の基本だよ。
「鑑別診断のループ」って呼ばれてるやつ。
機械屋:
、、素晴らしい。
おっしゃる通りです。まさに同じ構造ですね。
そして、ここにもうひとつ重要な要素があります。
「RAG」――Retrieval Augmented Generation、検索拡張生成です。
医療田:
RAG?
機械屋:
AIが回答を生成する前に、
外部の知識ベースから関連情報を検索して取り込む仕組みです。
これにより、AIの知識が「学習した時点」で止まらず、
最新の情報や専門文献に基づいた回答ができるようになる。
医療田:
あー、それは、、
UpToDateみたいなものだね。
診察中に「あれ、この薬の最新のガイドラインどうだっけ」って思ったら、
その場でUpToDateを検索して確認する。
AIもそれをやってるんだ。
機械屋:
まさにそうです。
RAGがないと、AIは「自分の記憶だけ」で答えるしかなく、
古い情報や間違った情報を自信満々に語る――いわゆるハルシネーションのリスクが高まります。
医療田:
カルテも見ず、ガイドラインも確認せず、
記憶だけで診断する医者みたいなものか。。
それは、、怖いね。
機械屋:
ええ。
だからこそ、エージェントAIにとってRAGは「必須の材料」なんです。
あとは、以前ご紹介したOpenEvidenceも、まさにRAGを活用したデカコーン――非上場でありながら時価総額100億ドル以上の巨大企業の総称ですが――に成長しましたね。
医療田:
ああ、Vol.57で解説してくれたよね。
米国の医師の過半数が使ってるっていう医療AI。
機械屋:
そうです。
最新の医学論文やガイドラインをRAGで検索・参照しながら回答を生成する。
2026年1月時点で時価総額120億ドル、日本円で約1.8兆円です。
RAGという「材料」が、それほどの価値を生んでいるということですね。
医療田:
、、すごいね。。
「材料」の話をしてるのに、規模感がすごい。
機械屋:
ええ。
そしてこの推論ループの中で、さっき話したHBMの帯域が効いてくる。
考えるたびに推論が走り、そのたびにメモリ帯域を使う。
ループの回数が多いエージェントAIほど、ハードウェアの性能が問われるわけです。
医療田:
ハードウェアとソフトウェア、全部つながってるんだ。
● まとめ
機械屋:
今回のポイントを整理しましょうか。
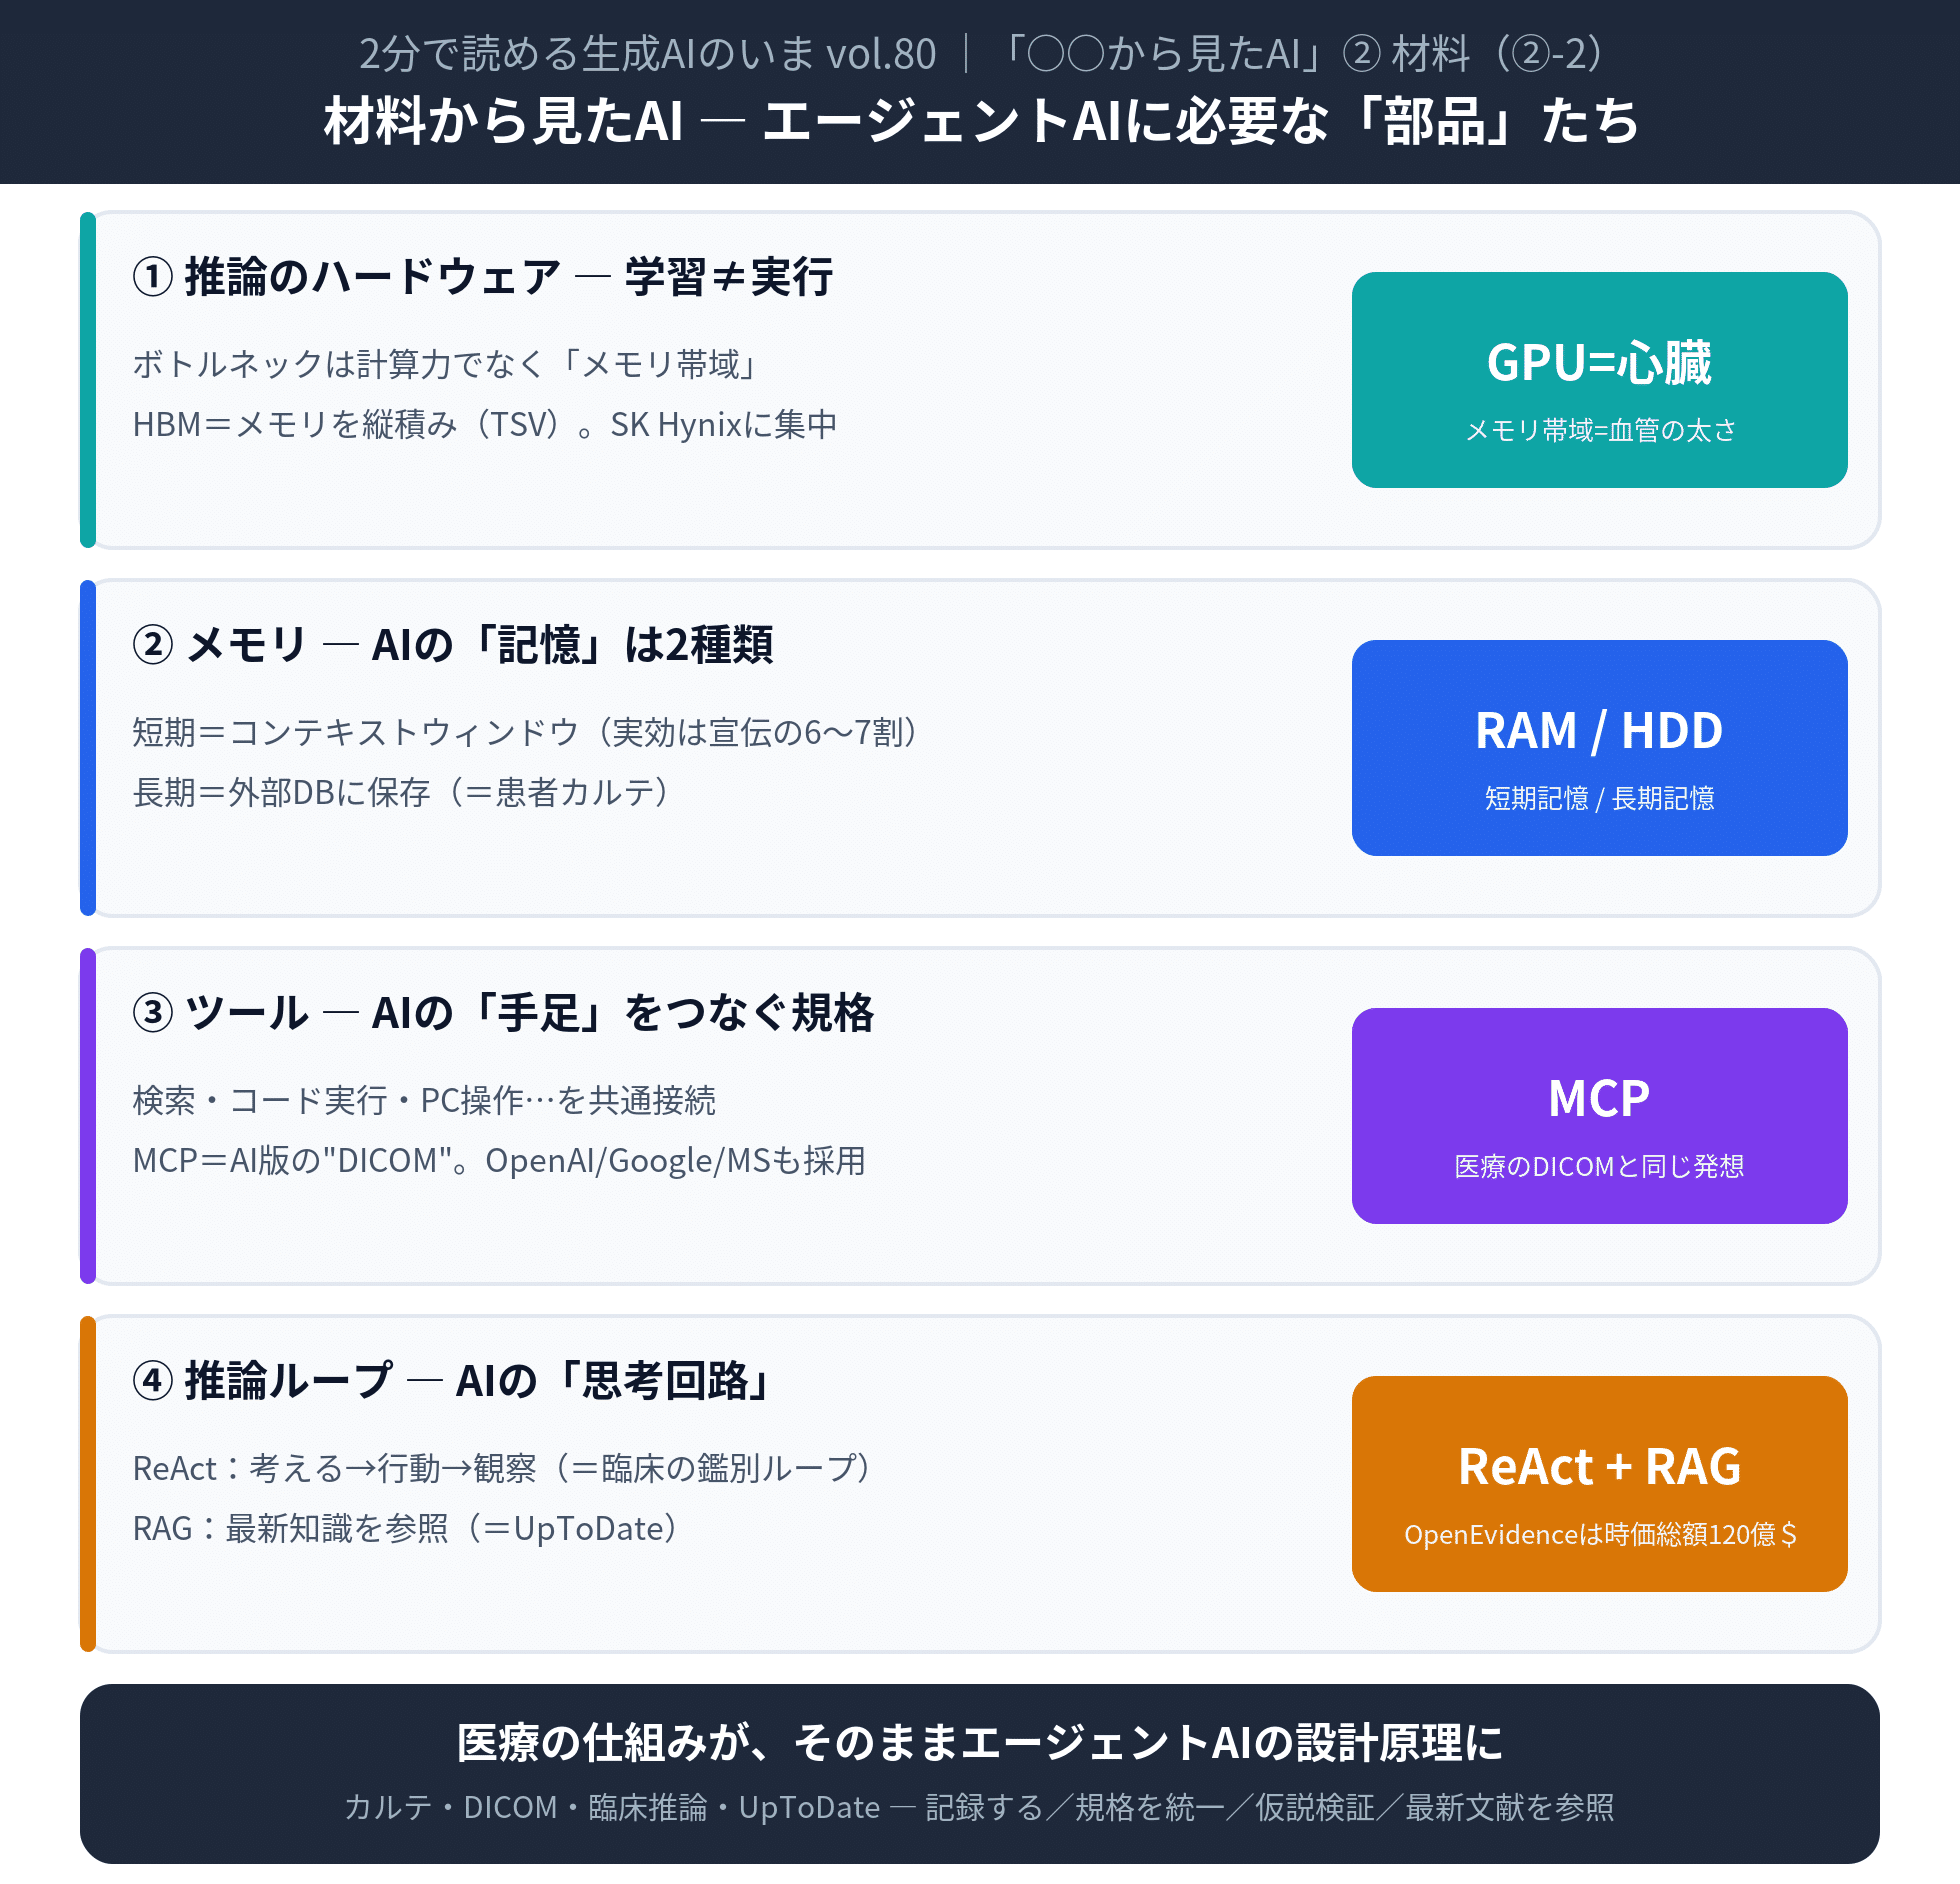
・エージェントAIの「実行」には「推論(インファレンス)」処理が必要で、そのボトルネックは計算力ではなくメモリ帯域。HBM(高帯域メモリ)がその鍵を握り、供給はSK Hynixに集中している。
・エージェントAIは1タスクに何度も推論を繰り返すため、推論コストの低下が普及の大前提。前回見た「3年で99.7%の下落」はこの文脈で決定的に重要。
・ソフトウェアの部品は主に3つ。メモリ(短期記憶のコンテキストウィンドウと、長期記憶の外部データベース)。ツール(MCPという共通規格でつなぐ)。推論ループ(ReActの「考える→行動する→観察する」サイクルと、RAGによる最新知識の参照)。
・医療の仕組み――カルテ、DICOM、臨床推論、UpToDate――は、そのままエージェントAIの設計原理と重なっている。
医療田:
今日の話、ハードウェアからソフトウェアまで一気に来たね。
しかも医療に近い概念ばかりで驚いた。
カルテ、DICOM、臨床推論、UpToDate。
機械屋:
ええ。
医療の世界が長い時間をかけて培ってきた仕組み――
記録を残す、規格を統一する、仮説検証を回す、最新文献を参照する――
それがそのままエージェントAIの設計原理になっている。
医療田:
なんかちょっと嬉しいかも。
医療の考え方が、AIの設計に活きてるっていうのは。
機械屋:
そうですね。
そしてこのシリーズの次は、いよいよ「地政学から見たAI」です。
今回出てきたHBMのSK Hynix、前回のレアアースと中国。。
これらの「材料」が世界のどこにあって、誰が握っているのか。
AI覇権競争の本丸に踏み込みます。
医療田:
やっぱり、怖いけど楽しみ。
======
● よくある質問(FAQ)
Q. AIの「学習(トレーニング)」と「推論(インファレンス)」の違いは何ですか?
A. 学習はAIモデルに知識を覚えさせるプロセスで、膨大な計算資源と時間を要します。推論は学習済みのモデルが実際に「考えて答える」プロセスで、リアルタイム性が求められます。学習のボトルネックはGPUの計算力、推論のボトルネックはHBMなどのメモリ帯域です。エージェントAIは推論を何度も繰り返すため、推論側のハードウェア性能とコストが特に重要になります。
Q. コンテキストウィンドウと長期メモリの違いは何ですか?
A. コンテキストウィンドウは、AIがいま処理している会話の範囲(短期記憶)です。容量に限りがあり、会話が長くなると古い情報から抜け落ちます。長期メモリは、重要な情報を外部データベースに保存し、必要な時に呼び出す仕組みです。人間の「診察中の頭の中」がコンテキストウィンドウ、「カルテ」が長期メモリにあたります。
Q. MCPとは何ですか?なぜ重要なのですか?
A. MCP(Model Context Protocol)は、AIがさまざまなツールやサービスと接続するための共通規格です。Anthropic社が2024年に発表し、OpenAI、Google、Microsoftも採用を表明しています。医療画像のDICOM規格と同じように、異なるツールを統一的なプロトコルでつなぐことで、開発コストの削減とエコシステムの拡大を可能にします。
Q. RAG(検索拡張生成)がないとAIはどうなりますか?
A. RAGなしのAIは、学習時に取り込んだ知識だけで回答するため、最新の情報に対応できず、「もっともらしいが間違った回答」(ハルシネーション)のリスクが高まります。医療でいえば、ガイドラインや文献を参照せずに記憶だけで診断するような状態です。RAGを導入することで、外部の知識ベースから最新・正確な情報を取得してから回答を生成できるようになります。
======
● 参考
High Bandwidth Memory (HBM): What It Is and Why It Matters for AI — Run.ai
https://www.run.ai/guides/machine-learning-engineering/high-bandwidth-memory
AI inference vs. training: What's the difference? — IBM
https://www.ibm.com/think/topics/ai-inference-vs-training
LLM Agent Architectures in 2026: Core Components and Patterns — FutureAGI
https://futureagi.com/blog/llm-agent-architectures-core-components/
State of AI Agent Memory 2026: Benchmarks & Trends — Mem0
https://mem0.ai/blog/state-of-ai-agent-memory-2026
Context Window Is RAM, Not Storage — Mem0
A Year of MCP: From Internal Experiment to Industry Standard — Pento
https://www.pento.ai/blog/a-year-of-mcp-2025-review
Model Context Protocol — Wikipedia
https://en.wikipedia.org/wiki/Model_Context_Protocol
Code execution with MCP: building more efficient AI agents — Anthropic
https://www.anthropic.com/engineering/code-execution-with-mcp
What Is RAG? How Retrieval-Augmented Generation Works in 2026 — Atlan
https://atlan.com/know/what-is-rag/
How AI Agents Work: Architecture and ReAct Cycle — GuruSup
https://gurusup.com/blog/how-ai-agents-work
●関連記事
- 2分で読める生成AIのいま Vol.79 材料から見たAI ②-1 ― シリコンから電力まで(本シリーズ・note)
https://note.com/41machida_ai/n/nb21b45c15500
- 2分で読める生成AIのいま Vol.68 AIエージェントの「中身」を知る(note)
https://note.com/41machida_ai/n/nab211b18ed89
- 2分で読める生成AIのいま Vol.57 米国医師の過半数が使う医療AI「OpenEvidence」(ブログ)
https://www.youichimachida-ai.com/blog/2ai-vol57aiopenevidence-
- 2分で読める生成AIのいま Vol.12 AI界を変える"マスター鍵"?! MCPについて(ブログ)
https://www.youichimachida-ai.com/blog/2aivol12-aimcp-
●2分で読める「生成AIのいま」シリーズ。バックナンバーはブログからどうぞ!
https://www.youichimachida-ai.com/blog
――――――――――
町田洋一(医師・医学博士・経営管理学博士)
Youichi MACHIDA, MD, PhD, DBA
