2分で読める生成AIのいま VOL.85 AIの評価から見る医学 ― 医学知見は"Truth"なのか"State-of-the-art"なのか
「ChatGPTとOpenEvidence、どっちが賢いの?」。院内の勉強会で出たこの質問から、今回の話は始まります。AIをどんな物差しで測るのかを見ていくと、そこに映っているのはAIの実力ではなく、私たちが医学をどう捉えているか、なのかもしれません。今回はちょっと辛口な医療田さんですが、実は私自身の心からの叫びでもあります 笑
(※2026年10月時点の情報です。)
今回も医療田さんと機械屋さんの会話でどうぞ。
======
● ”汎用AIと医療特化AI、どっちが賢い”?
医療田:
ねえ機械屋さん。
こないだ院内の勉強会で、OpenEvidenceを紹介したんだよ。
機械屋:
お、いいですね。
Vol.57でも取り上げましたが、アメリカの医師の過半数が使っている医療AIですね。
どんな反応でした?
医療田:
それがね、、
「で、ChatGPTとどっちが賢いの?」って聞かれちゃって。
機械屋:
ははは。。よく聞かれる質問ですね。
医療田:
うん。でも私、その質問自体がちょっと違うと思ってて。
うまく言えないんだけど。
機械屋:
ふむ、、おっしゃりたいことは何となくわかりますよ。
● OpenEvidenceと基盤モデルの棲み分け
機械屋:
では、まず整理から行きましょうか。
OpenEvidenceとは、医学論文や診療ガイドラインに根拠を置いて答える、医療専門のAI検索ツールのことです。
答えのひとつひとつに、元になった論文やガイドラインの引用が付いてきます。
医療田:
ふんふん。
機械屋:
一方、ChatGPTやGemini、Claudeは「汎用の基盤モデル」です。
基盤モデルとは、ネット上の膨大な文章を広く学習して、どんな話題にも答えられるように作られたAIのことです。
いわば、何でも知っている物知りな友人ですね。
医療田:
物知りな友人、、たしかに。
機械屋:
ただ、この友人には癖があります。
「いちばんもっともらしい答え」を作るように設計されているんです。
医療田:
もっともらしい、、?
機械屋:
はい。
言い換えると、その分野の人なら誰も否定しなさそうな答えに寄っていく。
専門家の「平均的な合意」を、流暢に再現するのが得意なんです。
医療田:
あー、、それ、すごく分かる。
しかもハルシネーション、つまりAIがもっともらしい嘘をつくやつね。
あれで間違ってても、なんとなく納得できちゃう形で出てくるんだよね。
機械屋:
そこが怖いところですね。
● 私、試してみたんだよ
医療田:
実はね、私の専門の乳がんで試したことがあるの。
乳がんの腋窩リンパ節転移、つまり脇の下のリンパ節への転移の、診断と治療について聞いてみた。
機械屋:
おお、ガチの比較ですね。
医療田:
汎用AIは、教科書みたいに整った答えをくれた。
間違ってはいない。
でも、どこかで読んだことのある話なんだよね。
機械屋:
ふむ。
医療田:
OpenEvidenceは違った。
「いま、腋窩の手術をどこまで省略できるか議論されている」
「こういう臨床試験が走っていて、こういう結果が出ている」って返してきたの。
学会の最新の議論とほぼ同じレベルで。
機械屋:
なるほど。
汎用AIは「答えを固定しよう」とする。
OpenEvidenceは「いま、どこが動いているか」を示そうとする。
向いている方向が、そもそも違うんですね。
医療田:
そうそう!それが言いたかった。
機械屋:
汎用AIは、学習した時点までの、しかも広く受け入れられた見解に引っ張られます。
ですから構造的に、少し「過去寄り」なんです。
まだ合意になっていない、議論のまっただ中の話がいちばん苦手です。
医療田:
でもさ、その「議論のまっただ中」こそ、臨床医がいちばん知りたいところなんだよ。
● 医学知見は"Truth"なのか"State-of-the-art"なのか
医療田:
ここからが本題なんだけど。
医学ってね、不変の真実じゃないと思うんだよ。
機械屋:
と、言いますと?
医療田:
いま行われている最新の治療って、ぜんぶ仮説の上に立ってるの。
「こうすれば良くなるはずだ」っていう仮説を、臨床試験で確かめてる途中。
新しいエビデンスや新しい疑問が出てきたら、当然揺れ動く。
機械屋:
50年前の標準治療が、いまは否定されている、ということもありますよね。
医療田:
いっぱいあるよ。
50年前とも違うし、50年後もきっと違う。
だから医学は「トゥルース」じゃない。
いちばん近い言葉は、ステートオブジアートかな。
機械屋:
ステートオブジアートとは、「その時点での最先端」「現時点の最善」という意味の言葉ですね。
医療田:
そう。
サイエンスとアート、って言い方もあるでしょ。
真実を見定めようとするのがサイエンス、人の営みを突き詰めるのがアート、みたいな。
機械屋:
はい。
医療田:
でも医学って、どっちか一方には割り切れないんだよね。
真実を追いかけながら、同時に、いま人間に何ができて何が分かっているかっていう、人の営みでもある。
きれいに割り切れない。。
だから、固定した「真実」にはならない。
機械屋:
近代医学の父と呼ばれるウィリアム・オスラーの言葉にも、近いものがありますね。
「医学は不確実性の科学であり、確率の技芸である」。
医療田:
あー、それそれ。
100年以上前から、ちゃんと言われてたんだね。
● Nature Medicineの論文を読んで、私はちょっと考え込んだ
機械屋:
実は、この話にぴったりの論文があります。
2026年6月、Nature Medicineに、汎用AIが医療特化型AIツールを上回った、という研究が載りました。
医療田:
知ってる。読んだよ。
OpenEvidenceより、ChatGPTやGeminiやClaudeのほうが成績が良かったってやつでしょ。
機械屋:
はい。評価は3段構えでした。
ひとつは、米国の医師国家試験形式の問題での正答率。
ふたつめは、専門家の医師の考えとどれだけ一致するかを測る評価。
みっつめは、医師が実際にAIに投げた質問への回答を、臨床医12人が、どのAIの答えか伏せて採点したものです。
医療田:
うん。
試験だけじゃなくて、現場の質問まで見てるのは、ちゃんとしてると思う。
機械屋:
ええ。
医療田:
でもね、正直に言うと、読んでて
「この物差しで、『どっちが優れているか』まで言い切っていいのかな」って思っちゃったんだよ。
機械屋:
なるほど。さすがですね。
医療田:
だってさ、試験問題の「正解」は、その時点での合意でしょ。
専門家との一致度も、結局は「いまの専門家の考えに、どれだけ近いか」。
臨床医の採点も、「良い答えかどうか」を見てる。。
でも、患者さんに対する最善のアプローチって、その時々の最新の知見や論文、学会発表、ガイドラインの改訂で変わっていくでしょ。
目の前のその人に、どんなアプローチがいちばんいいのか。
それって、正解がない中で模索しているものだと思うんだよね。
機械屋:
。。たしかに。
どれも「いまの合意に照らして、良い答えか」という物差しですね。
その物差しなら、合意を流暢に再現するのが得意な汎用AIが強いのは、ある意味自然です。
医療田:
でしょ?
「いま、どこで議論が割れているか」を示せるか。
「その根拠を、自分でたどって確かめられるか」。
私がいちばん価値を感じているところは、物差しになっていないの。
機械屋:
ちなみに、著者たちも、引用の質や応答の速さといった実用面は今後きちんと比較すべきだ、と書いています。
OpenEvidenceがいちばん売りにしている「根拠をたどれること」は、今回の評価の中心ではなかったんです。
医療田:
そこなんだよね。
● AIは鏡。映っているのは、こっちの医学観
機械屋:
今のお話、つまりこういうことでしょうか。
AIを「真実の機械」だと思っているかどうか、という話ではない。
医療田:
そう、そこ大事。
AIをどう評価して、どう使うか。そのやり方を見ると、
その人が医学を「真実」と思ってるのか、「ステートオブジアート」と思ってるのかが見えちゃうの。
機械屋:
AIは鏡で、物差しの選び方に、評価する人の医学観が映ってしまう。
医療田:
うん。
だから、この結果を見て「やっぱり汎用AIのほうが優秀なんだ」って受け取ったとしたら、
そこには、その人の医学観が出ちゃう気がするんだよ。
機械屋:
なかなか辛口ですね。入口はAIの比較に見えて、本当の主題は「私たちは医学を何だと思っているのか」なんですね。
● ひとつの分野だけで見ると、、
医療田:
ここは、医者の私が自分のこととして言うね。
機械屋:
はい。
医療田:
ひとつの分野をずっと深く学んでいくと、どうしても目線がひとつになりがちだと思うの。
医学部も、卒業するまで「問いに正しく答える」練習が長いしね。
機械屋:
医学部時代、、ですか。
医療田:
いや、医学部時代のことは、、あまり思い出したくない 笑
それはいいとして。
機械屋:
ははは。。失礼しました。
医療田:
問いに正しく答える力、それ自体は大事なんだけど、
判断の軸がちょっと少なくなりがちだったり、近視眼的になりがちだったり。
物事を立体的に見るのが、少し難しくなるかもしれないよね。
私も、その教育を通ってきたひとりだから、他人事じゃないんだけど。
機械屋:
分野の外から来たもの、たとえばAIを見るときに、その影響が出やすいのかもしれませんね。
片目で見ると、奥行きがつかみにくいのと似ています。
医療田:
そうそう。立体視できない感じ。
● もし、物差しを持たずに測るとしたら
医療田:
ねえ機械屋さん、ちょっとたとえ話していい?
機械屋:
どうぞどうぞ^^
医療田:
たとえば、小学生が政治の話をすると、
「この人はいい人、あの人は悪い人」ってなりやすいじゃない。
機械屋:
ははは。。なりやすいですね。
医療田:
でも実際の政治は、そんなに簡単じゃないよね。
それぞれの立場に、それぞれの考えがある。
機械屋:
ええ。
医療田:
だとすれば、だよ。
もしAIの評価が、「どっちが賢いか」っていう二択になっちゃうんだとしたら、
それは、評価する側の物差しがまだ足りない、ってことなのかもしれない。
機械屋:
なるほど。
AIを評価するには、科学とは何か、学問とは何か、評価とは何か、といった、医学の外の教養も要る。
物差しは、ひとつの分野を深く掘るだけでは手に入りにくい。
いくつもの知が交わるところに、立ち上がってくるものなんですね。
医療田:
うん。
物差しを持たずに、サイエンスは測れないと思う。
● だから、学び続ける
医療田:
ここは、本当に声を大にして言いたいんだけど。
機械屋:
はい。
医療田:
AIが出てきて、「もう勉強しなくていいじゃん」って言う人がいるでしょ。
私は、まったく逆だと思ってる。
AIをここまで育ててきたのは、人の意思と、知識と、経験なんだよ。
そして、これからAIをどっちに導いていくかを決めるのも、結局は人。
AIを評価するのも、使うのも、作るのも、一緒に過ごしていくのも、人なの。
そのときに、何を物差しにするか。何を大事だと思うか。
それを決めるのは、その人が何を学んで、何を経験してきたか、なんだよね。
だから私たちは、必死に学ばないといけない。
医学だけじゃなくて、いろんなことを学んで、いろんなことを経験しないといけない。
ちょっとしんどいけどね。。
機械屋:
でも、それは希望でもありますよ。
道具が賢くなるほど、使い手の学びが意味を持つ。
人が学ぶことの価値は、AIの時代にむしろ上がっているとも言えます。
● まとめ
機械屋:
今回の教訓をまとめましょうか:
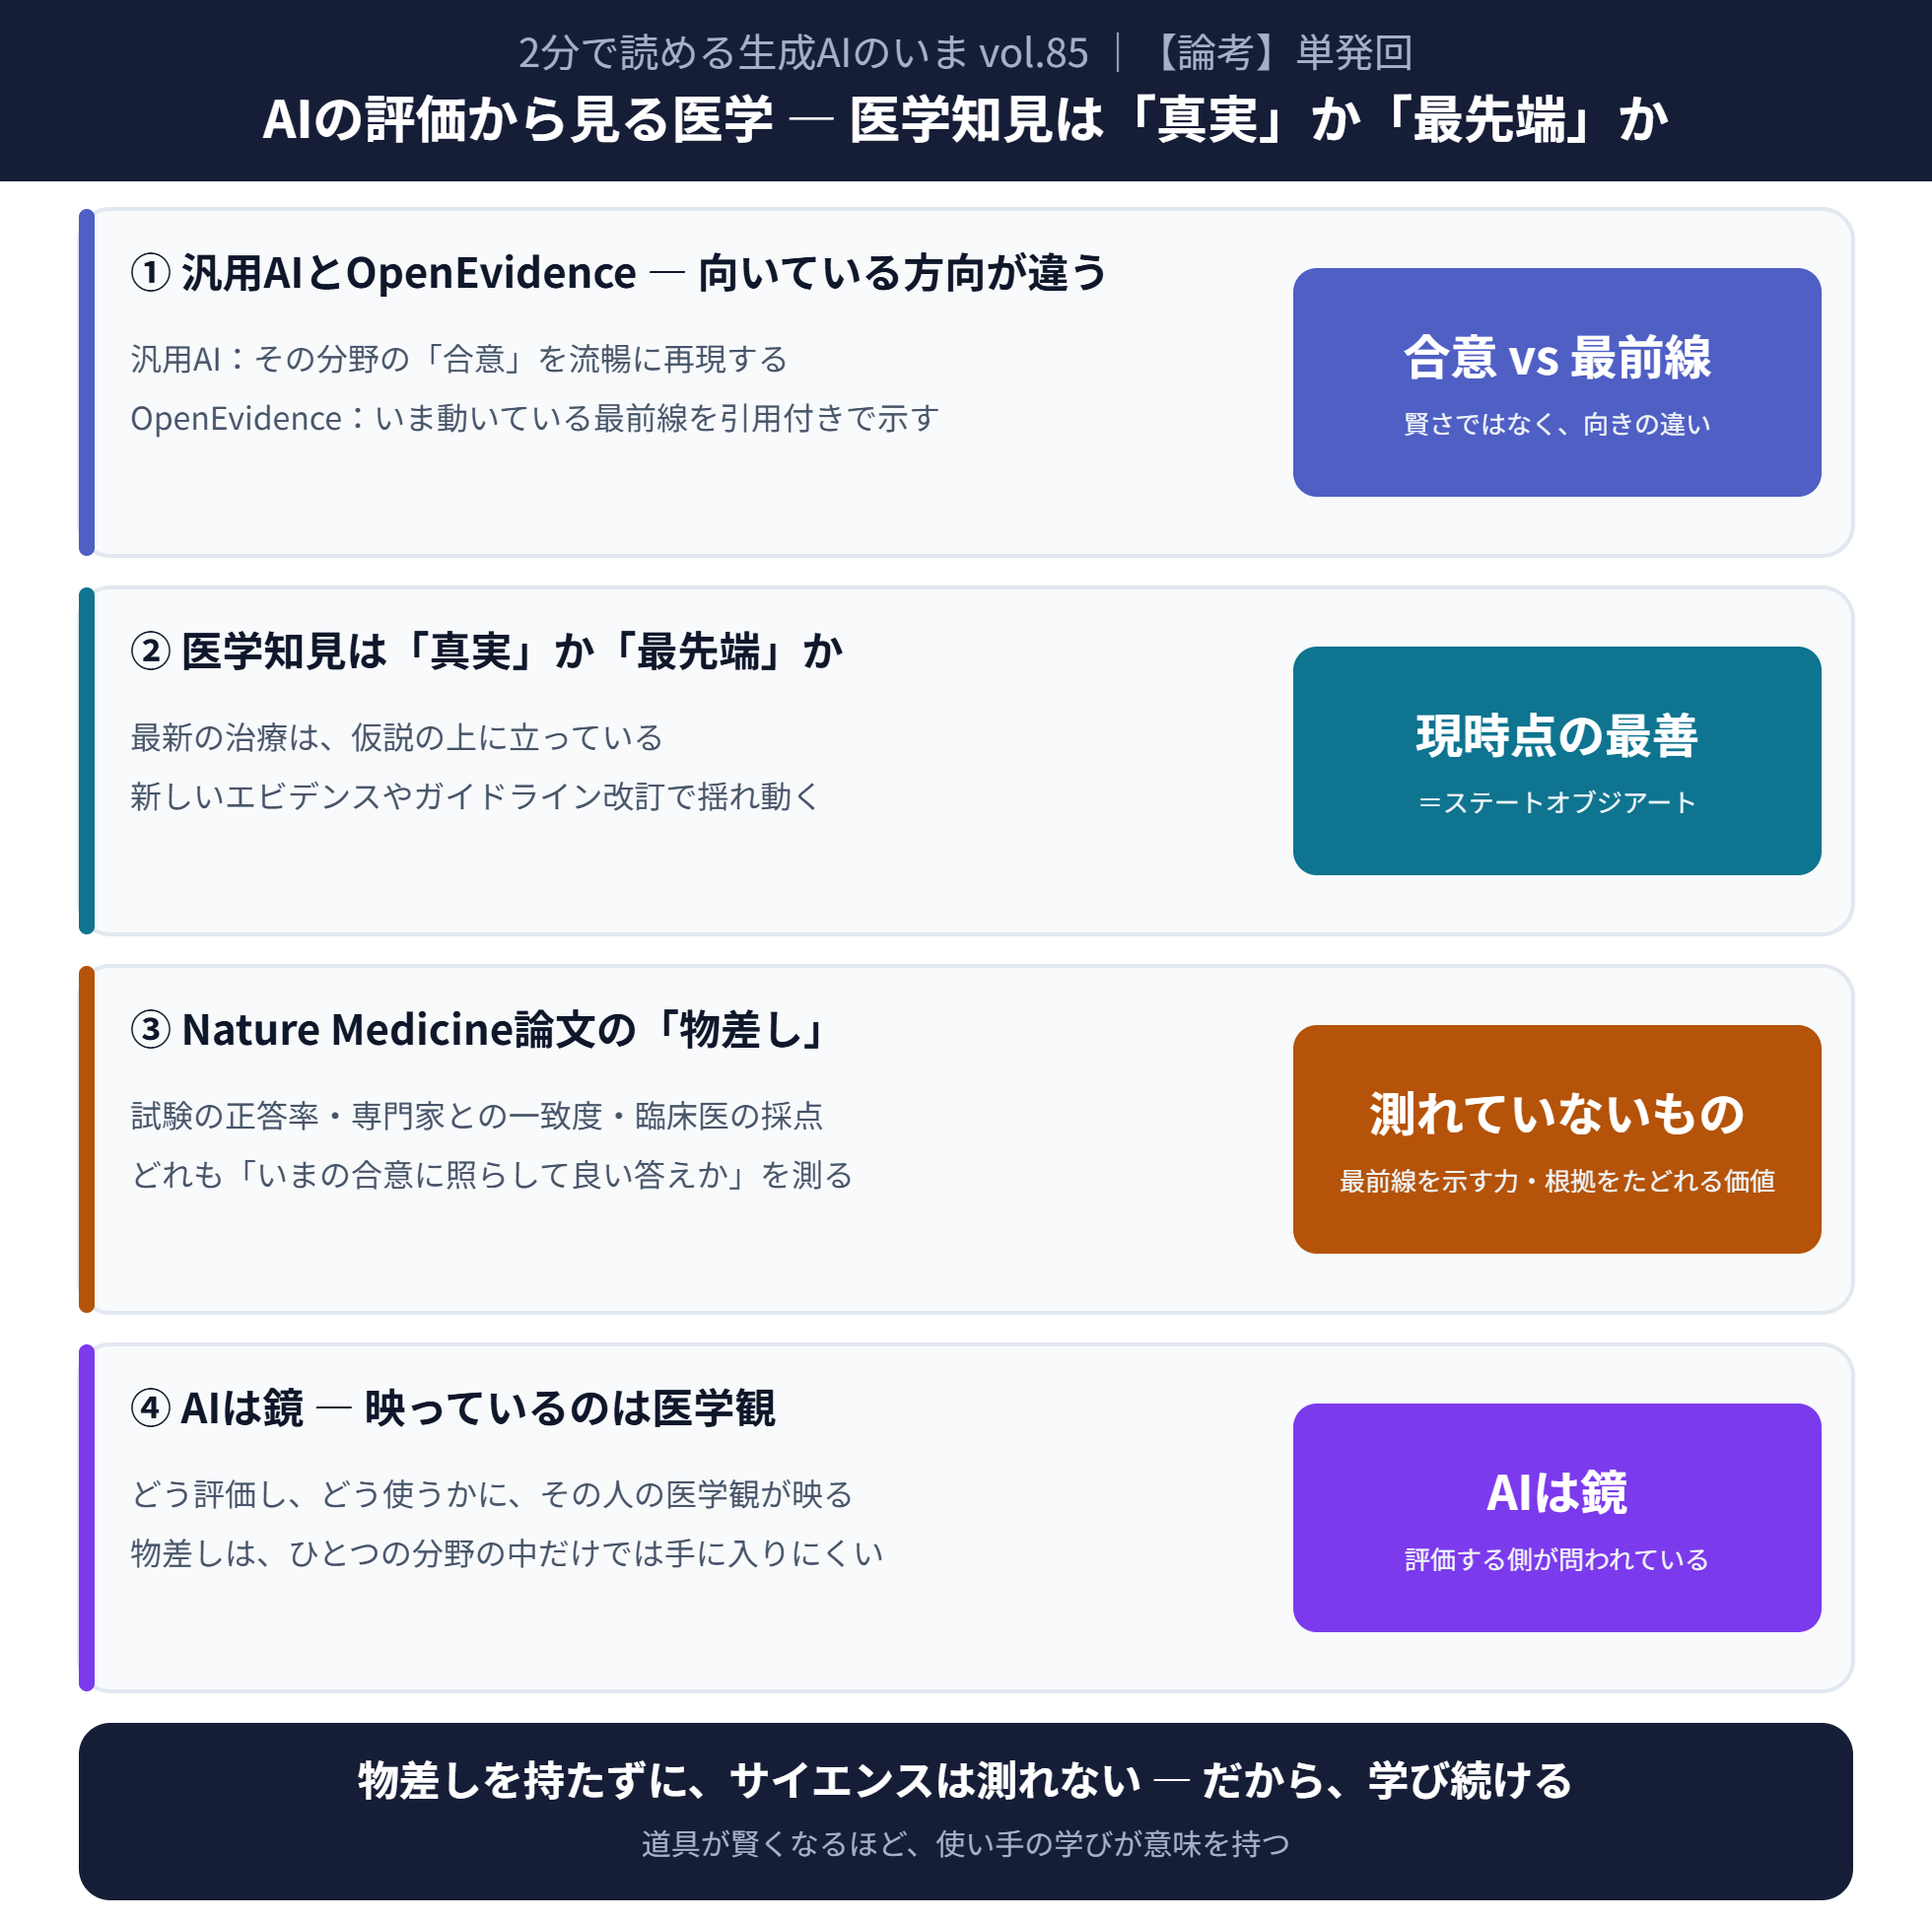
・汎用AI(ChatGPT、Gemini、Claude)は「その分野の合意」を流暢に再現するのが得意。いま議論が動いている最前線は苦手。
・OpenEvidenceは、論文やガイドラインに根拠を置き、「いま何が議論され、どんな試験が走っているか」を引用付きで示す。
・医学知見は不変の真実(Truth)ではなく、仮説の上で揺れ動く「State-of-the-art(現時点の最善)」。
・「いまの合意に照らして良い答えか」という物差しだけでは、最前線を示す力や、根拠をたどれる価値は測りきれない。
・AIをどう評価するかには、評価する人の医学観が映る。AIは鏡。
・物差しは医学の中だけでは手に入りにくい。だからAIの時代こそ、人は学び続ける。
医療田:
、、なんだか、AIの話をしてたはずなのに、
最後は自分の話になっちゃったね。
機械屋:
ええ。
でも、それがこの話のいちばん大事なところかもしれません。
AIを見ているつもりで、じつは自分の物差しを見ている。
医療田:
、、鏡、か。
どこかで読んだけど、
「学べば学ぶほど、自分が無知であることを知る」って言うじゃない?
機械屋:
アインシュタインの言葉として、よく引用されますね。
ソクラテスの「無知の知」にも通じます。
医療田:
うん。
無知を知ってるから、学び続けられる。
AIの時代でも、そこは変わらないんだと思う。
機械屋:
はい。
答えを持っていることより、問い続けられることのほうが、
これからはずっと大事になるのかもしれませんね。
医療田:
、、よし。
まずは今夜、積んでる論文を一本読もう。
機械屋:
ははは。。一本からで十分です^^
======
● よくある質問(FAQ)
Q1. OpenEvidenceとChatGPTなどの汎用AIの違いは何ですか?
A1. ChatGPT・Gemini・Claudeなどの汎用の基盤モデルは、広く学習した知識から「もっともらしい答え」を作るため、その分野の合意を流暢に再現するのが得意です。OpenEvidenceは医学論文や診療ガイドラインに根拠を置き、引用付きで「いま何が議論されているか」を示す医療専門のAI検索ツールです。違いは賢さではなく、向いている方向にあります。
Q2. Nature Medicineの研究では、なぜ汎用AIのほうが成績が良かったのですか?
A2. 2026年6月の研究は、医師国家試験形式の問題、専門家との一致度、実際の臨床質問への盲検採点という3つの方法で評価し、いずれも汎用AIが上回りました。ただ、どの評価も「いまの合意に照らして良い答えか」を測る物差しであり、合意の再現が得意な汎用AIに有利に働いた面があります。著者自身も、引用の質など実用面の比較は今後の課題としています。
Q3. 医学が「Truth」ではなく「State-of-the-art」とはどういう意味ですか?
A3. 医療の最新の治療は仮説の上に立っており、新しいエビデンスやガイドラインの改訂によって変わり続けます。つまり医学知見は不変の真実ではなく、「その時点での最善(ステートオブジアート)」です。AIを評価するときも、この動的な性質を前提にした物差しが必要になります。
Q4. AIの時代に、なぜ人は学び続ける必要があるのですか?
A4. AIを評価し、使い、作り、方向づけるのは人だからです。何を物差しにし、何を大事と考えるかは、その人が何を学び、何を経験してきたかで決まります。道具が賢くなるほど、使い手の学びの価値はむしろ上がります。
● 参考
1. General-purpose large language models outperform specialized clinical AI tools on medical benchmarks — Nature Medicine (2026)
https://www.nature.com/articles/s41591-026-04431-5
2. General-purpose AI beats out specialized clinical AI in some assessments — TechTarget (2026)
3. ChatGPT, Gemini, Claude outperform clinical AI tools: Study — Becker's Hospital Review (2026)
●関連記事
- 2分で読める生成AIのいま Vol.57 米国医師の過半数が使う医療AI「OpenEvidence」― 利用そのものが「データ資産」になる時代(ブログ)
https://www.youichimachida-ai.com/blog/2ai-vol57aiopenevidence-
- 2分で読める生成AIのいま Vol.72 「バーティカルAI」って何? ― 医療AIは国策になった(note)
https://note.com/41machida_ai/n/n3d6165ee94e7
- 2分で読める生成AIのいま Vol.18 生成AIの効能を医師の目線で検証するには(ブログ)
https://www.youichimachida-ai.com/blog/2aivol18-ai
- 2分で読める生成AIのいま Vol.54 生成AI時代の「理解負債」(ブログ)
https://www.youichimachida-ai.com/blog/2ai-vol54ai-ai
●2分で読める「生成AIのいま」シリーズ。バックナンバーはブログからどうぞ!
https://www.youichimachida-ai.com/blog
――――――――――
町田洋一(医師・医学博士・経営管理学博士)
Youichi MACHIDA, MD, PhD, DBA
